
Java基础:ThreadLocal及其原理
ThreadLocal是一个多线程的辅助工具类,目的是方便开发者维护多线程中的共享变量。我们知道如果我们想要在一个线程中一直访问一个变量或者在线程上下文中保存一个变量,我们要么将该变量声明为static静态,要么就在每一步函数调用中均传入该变量。这两种方式,static方式不能解决每个线程同时分别持有的问题。每一步函数传入对代码的侵入性过高。
ThreadLocal是一个多线程的辅助工具类,目的是方便开发者维护多线程中的共享变量。我们知道如果我们想要在一个线程中一直访问一个变量或者在线程上下文中保存一个变量,我们要么将该变量声明为static静态,要么就在每一步函数调用中均传入该变量。这两种方式,static方式不能解决每个线程同时分别持有的问题。每一步函数传入对代码的侵入性过高。
面试被问到一个很有意思的问题:大循环和小循环,哪个在外哪个在里有区别吗?为什么?哪种更快?

公司要求提升单元测试的质量,提高代码的分支覆盖率和行覆盖率,安排我研究单元测试,指定方案分享并在开发部普及开。整理完资料后,同步一下到博客。
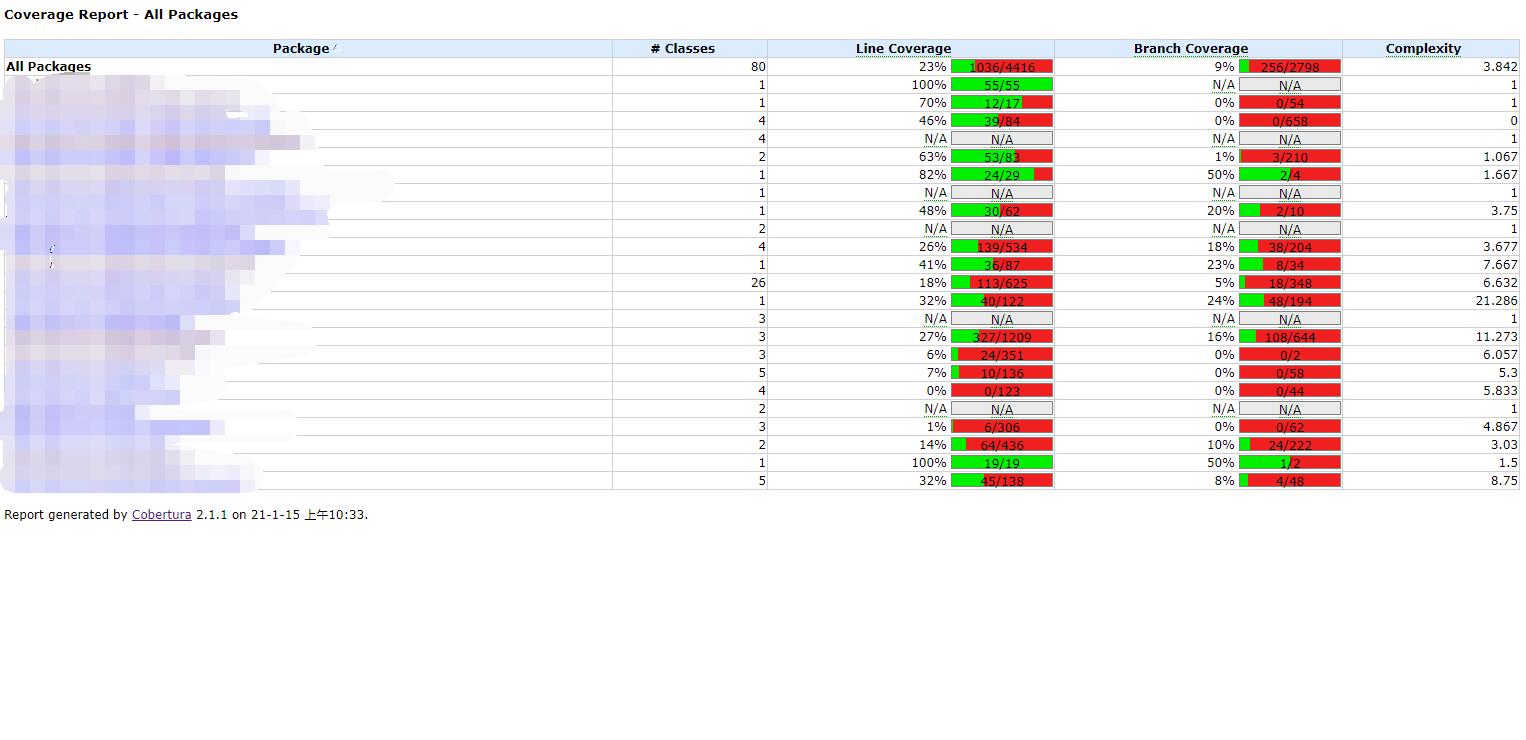
公司要求提升单元测试的质量,其中我作为方案和推动的主导,对开发过程中的单元测试,有了一些思考和总结
数据库扩容一般都是随着系统建设一步步演进的,所以这里随着系统的演进,一一介绍扩容的方案。
起因是一次面试,一次面试某电商网站,前面问到缓存,分布式,业务这些,还相谈甚欢。然后面试官突然甩出一句:“了解dubbo吗?dubbo是长连接还是短连接?”。当时我主要接触了解学习的还是spring cloud,dubbo作为知名的分布式rpc框架,只是有一定了解,并且连接这一块并没有很深入去了解,但是基于对分布式系统的了解,我不假思索的回答了:“长连接啊!”。其实分布式系统接触多了就知道了,分布式系统为了应对高并发,减少在高并发时的线程上下文切换损失以及重新建立连接的损失,往往都是采用长连接的。所以我当时我是这么想的:“dubbo作为处理小数据高并发分布式RPC框架,如果采用短连接,应该不可能达到那么高的吞吐吧。”。所以果断回答了长连接。可是没想到面试官微微一笑,带着几分不屑的说道:“短连接”。当时就给我整懵逼了,无法想象短连接如何处理高并发下重复建立连接以及线程上下文切换的问题。导致我回家的地铁上一直都处在怀疑人生的状态,回家后立马各种百度Google(甚至还怀疑查到的结果)。
Java编译期注解处理器,Annotation Processing Tool,简称APT,是Java提供给开发者的用于在编译期对注解进行处理的一系列API,这类API的使用被广泛的用于各种框架,如dubbo,lombok等。
近日学习Netty,在看书和实践的时候对于书上只言片语的那些话不是十分懂,导致尝试写例子的时候遭遇各种不顺,比如decoder和encoder还有HttpObjectAggregator的添加顺序,研究了一番之后和大家分享一下自己的理解,希望后来人可以少走弯路。