这章主要介绍了信号量的使用,如何使用信号量来实现并发编程。
信号量的定义
sem_init(&s, 0, 1);
初始化语句,第二个参数0表示是线程间的(信号量也存在进程间的),1表示信号量的值value
int sem_wait(sem_t *s) { // Decrement the value of semaphore s by one // Wait if the value of semaphore s is negative }
信号量的等待语句,将信号量的值减1,如果减1后的值为负数,那么就进入wait等待
int sem_post(sem_t *s) { // Increment the value of semaphore s by one // If there are one or more threads waiting, wake one }
可以认为信号量的唤醒语句,将信号量的值加1,如果此时有正在等待的线程,那么唤醒其中一个线程
注意这里的wait注释的顺序和实际的逻辑可能会有些差异,实际上并不是每次都会减一,在value值已经是负数(或许是0)时,
会直接进入阻塞。在多个线程阻塞wait时,一次post唤醒以后加1,再由被唤醒的线程-1,然后再post,然后一直在0和1之间来回循环,直到所有线程被唤醒执行完毕(可以主要看生产以及消费者队列)
信号量实现并发
信号量实现锁
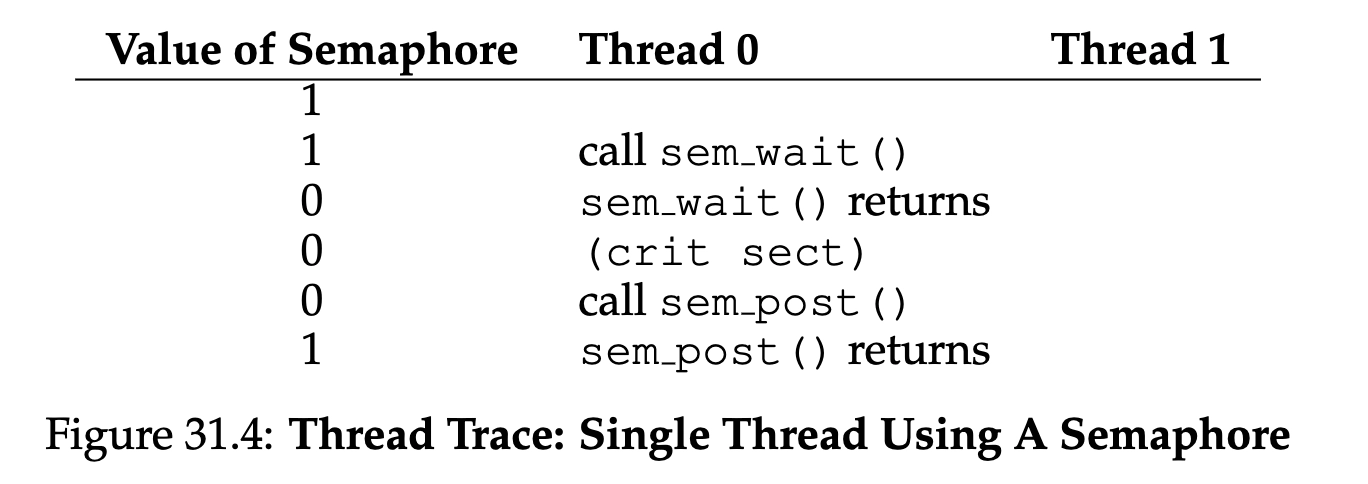
只需要将信号量的value设置为1,就可以实现一个锁,执行过程如下图:
- 第一个线程执行wait时,value修改为了0,但是此时是非负数,所以继续执行
- 当第二个线程再次去wait时,value从0修改为了-1,然后进入了阻塞等待
- 第一个线程执行post,将值+1,然后此时唤醒等待中的线程
信号量实现两个线程按顺序执行
sem_t s;
void* child(void* arg) { printf("child\n"); sem_post(&s); // signal here: child is done return NULL;}
int main(int argc, char* argv[]) { sem_init(&s, 0, X); // X should be 0 printf("parent: begin\n"); pthread_t c; pthread_create(&c, NULL, child, NULL); sem_wait(&s); // wait here for child printf("parent: end\n"); sem_destroy(&s); // Clean up semaphore return 0;}这里需要理解一个点,父子线程的执行顺序可能乱序,但是信号量通过他的语义依旧能保证按顺序执行。
父线程的wait先执行: 此时value=-1,然后子线程执行post,value回到0并且唤醒父线程
子线程的post先执行:此时value变成1(0+1),然后父线程执行wait,将value-1,减1后value还是0,不需要阻塞,直接继续执行,依旧保证了顺序。
消费者生产者(限界队列)问题
这里分几个步骤,才能讲清并发下会出现的问题
基本实现
int buffer[MAX];int fill = 0;int use = 0;
void put(int value) { buffer[fill] = value; // Line F1 fill = (fill + 1) % MAX; // Line F2}
int get() { int tmp = buffer[use]; // Line G1 use = (use + 1) % MAX; // Line G2 return tmp;}
sem_t empty;sem_t full;
void* producer(void* arg) { int i; for (i = 0; i < loops; i++) { sem_wait(&empty); // Line P1 put(i); // Line P2 sem_post(&full); // Line P3 } return NULL;}
void* consumer(void* arg) { int tmp = 0; while (tmp != -1) { sem_wait(&full); // Line C1 tmp = get(); // Line C2 sem_post(&empty); // Line C3 printf("%d\n", tmp); } return NULL;}
int main(int argc, char* argv[]) {
sem_init(&empty, 0, MAX); // MAX are empty sem_init(&full, 0, 0); // 0 are full //more code return 0;} 基本实现通过empty和full两个信号量,其中empty的值是value,生产者每次将empty减1(wait),并且对full加1(post),当生产的足够多时,如果生产速度大于消费速度,empty就从max变为负数,此时生产者进入等待。
消费者每次对full进行-1,同理,消费速度大于生产速度时,那么消费者就进入阻塞等待。
这种实现在单消费者和单生产者时可以正常运作,但是在多消费者和多生产者时,get和put方法本身会出现并发问题,这点稍微理解下就知道,这两个操作不是原子操作
优化,但是会死锁
void* producer(void* arg) { int i; for (i = 0; i < loops; i++) { sem_wait(&mutex); // Line P0 (NEW LINE) sem_wait(&empty); // Line P1 put(i); // Line P2 sem_post(&full); // Line P3 sem_post(&mutex); // Line P4 (NEW LINE) } return NULL;}
void* consumer(void* arg) { int i; for (i = 0; i < loops; i++) { sem_wait(&mutex); // Line C0 (NEW LINE) sem_wait(&full); // Line C1 int tmp = get(); // Line C2 sem_post(&empty); // Line C3 sem_post(&mutex); // Line C4 (NEW LINE) printf("%d\n", tmp); } return NULL;}临界问题?那简单,我加个互斥的锁不就好了?上面代码对get和put中加了锁,但是会导致新的问题:死锁。
这里会出现一个很简单的死锁,当消费者先拿到锁后,并进入full的信号量等待,此时生产者永远拿不到锁,永远无法进入put去生产,两个线程一个永久在等待锁(生产者),一个永久在等待生产者生产内容(消费者),两个线程死锁了。
最终解决,更换一下锁和等待的顺序
void* producer(void* arg) { int i; for (i = 0; i < loops; i++) { sem_wait(&empty); // Line P1 sem_wait(&mutex); // Line P1.5 (MUTEX HERE) put(i); // Line P2 sem_post(&mutex); // Line P2.5 (AND HERE) sem_post(&full); // Line P3 }}
void* consumer(void* arg) { int i; for (i = 0; i < loops; i++) { sem_wait(&full); // Line C1 sem_wait(&mutex); // Line C1.5 (MUTEX HERE) int tmp = get(); // Line C2 sem_post(&mutex); // Line C2.5 (AND HERE) sem_post(&empty); // Line C3 printf("%d\n", tmp); }}这样你会发现,消费者或者生产者会先一步进入等待条件变量再获取锁,这种解决方式其实你可以等价于在get和put方法中的开始和结束加入了锁,减小了锁的粒度,避免了死锁。
Read-Write Lock 读写锁
void rwlock_acquire_readlock(rwlock_t* rw) { sem_wait(&rw->lock); rw->readers++; if (rw->readers == 1) // first reader gets writelock sem_wait(&rw->writelock); sem_post(&rw->lock);}
void rwlock_release_readlock(rwlock_t* rw) { sem_wait(&rw->lock); rw->readers--; if (rw->readers == 0) // last reader lets it go sem_post(&rw->writelock); sem_post(&rw->lock);}
void rwlock_acquire_writelock(rwlock_t* rw) { sem_wait(&rw->writelock);}
void rwlock_release_writelock(rwlock_t* rw) { sem_post(&rw->writelock);}这个锁的实现其实和锁比较类似,只不过区分读写锁,这里只说下读写锁的特性:
- 获取读锁时
- 首先读锁操作都需要一个大锁来保证读锁数量++的并发正确性。
- 如果当前没有读锁,自己是第一个读锁持有者,那么去获取写锁,获取写锁成功后继续。
- 如果已经有读锁了,那么就读锁持有+1
- 释放读锁时,判断如果当前自己是最后一个持有读锁的(读锁持有数为0),那么释放写锁。
- 获取写锁时,直接获取写锁即可。
这样的方式可以保证读写锁的特性:可以多个线程同时读,但是在读写互斥,写操作之间本身也是互斥的。
读写锁只适合多读少写场景,但是会有较大写饿死的风险。
餐叉问题
这个问题我感觉实际意义不大,这里就不再总结了,主要表达了和前面生产消费者类似的问题,通过更换锁或者条件的依赖,来避免死锁。
Thread Throttling
线程节流,其实就是限流,我们可以通过控制信号量的值n,来做到只有n个线程能进入某段代码执行(相当于一个可以持有n个的令牌),多余的线程会被阻塞。以此来达到对系统某些资源使用的限流控制(比如大内存使用,大量计算,比较重的I/O)。
信号量自身的实现
我们通过锁和条件变量就能实现信号量:
typedef struct __Zem_t { int value; pthread_cond_t cond; pthread_mutex_t lock;} Zem_t;
// only one thread can call thisvoid Zem_init(Zem_t* s, int value) { s->value = value; Cond_init(&s->cond); Mutex_init(&s->lock);}
void Zem_wait(Zem_t* s) { Mutex_lock(&s->lock); while (s->value <= 0) Cond_wait(&s->cond, &s->lock); s->value--; Mutex_unlock(&s->lock);}
void Zem_post(Zem_t* s) { Mutex_lock(&s->lock); s->value++; Cond_signal(&s->cond); Mutex_unlock(&s->lock);}我们通过2种简单的语义实现了一个更好用的工具。
有一个很有意思的点:使用信号量来实现条件变量这件事会很困难。
在windows上很多程序员尝试这么做,但是他们写出了更多的bug。
个人猜测,例如条件变量中的broadcast广播通知,使用信号量就会很难实现。虽然可以通过while+post来实现类似的效果,但是这样就有了次序,不能达成同时唤醒的效果了。同时,如果被唤醒的线程又会对信号量进行处理并且进入wait,那么有些线程就会一直得不到唤醒。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 805 天
部分内容可能已过时