线上排查:线上pod内存问题
现象
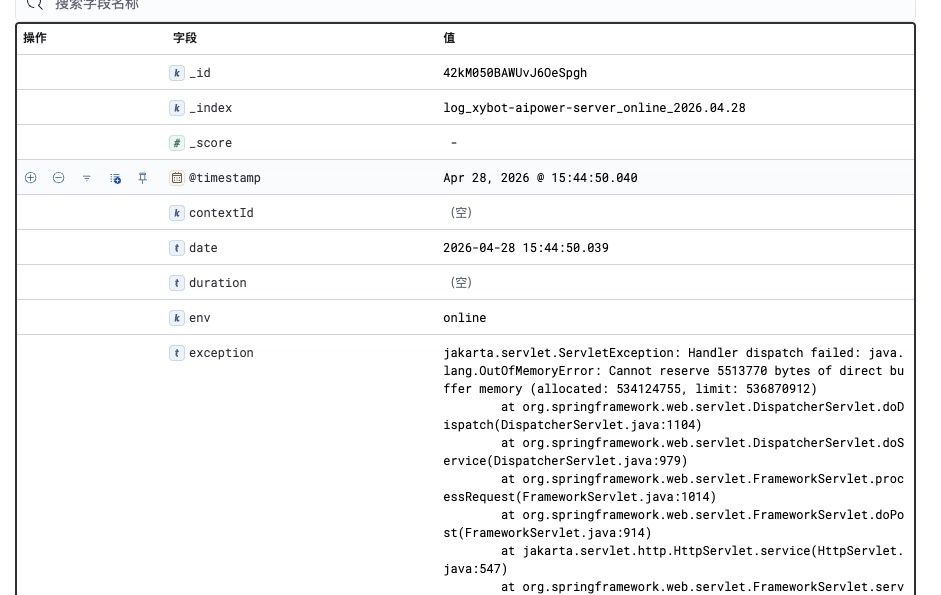
线上出现报错,客户反馈无法使用开放api上传文件
查看日志,有大量直接内存不足无法申请空间报错的日志,确实是该接口触发
影响范围
当时重启恢复前,从报错日志看,约1000多条opai上传文件请求/file/upload报错受到影响
解决方案
内存问题,直接联系运维重启,重启pod后功能恢复
排查过程
恢复后排查问题根因
首先尝试在pod内下载arthas,排查内存情况,发现arthas无法连接到pod,查看日志,arthas连接java进程也是使用的netty,会使用到直接内存,因为直接内存已经无法申请了,arthas也无法使用,改为使用jcmd命令排查
使用 jcmd 1 VM.native_memory summary 查看内存使用情况
查看内存发现,内存中Others部分基本打满500MB,java中直接内存一般会在这部分里面统计
Other (reserved=513916KB, committed=513916KB)
(malloc=513916KB #783) (peak=525555KB #783)
使用 jcmd 1 GC.run 直接触发GC,观察内存回收情况
直接触发GC以后,Other部分只回收了几十K,可见确实是内存泄漏或者异常占用
使用 jcmd 1 GC.heap_dump /tmp/heap.hprof 进行内存dump排查
dump内存后使用MAT分析,从DirectByteBuffer开始分析。
SELECT x.capacity FROM java.nio.DirectByteBuffer x
capacity是实际占用的内存
为了方便对比异常内存,在晚上和第二天早上分别dump,对比分析排查
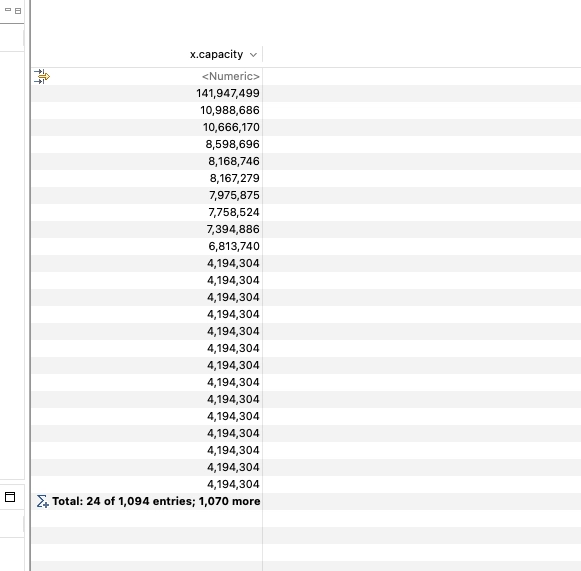
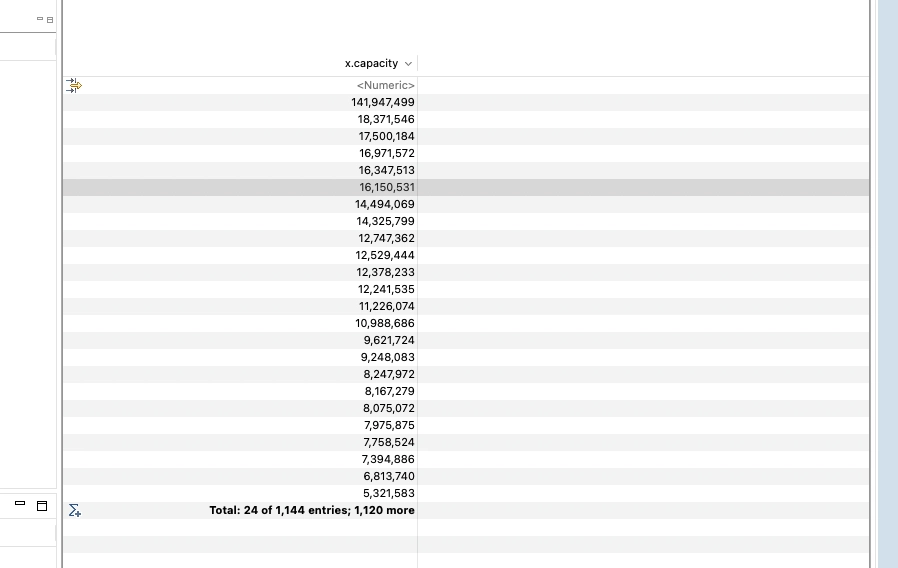
其中占用直接内存最大的部分,查看GC Path,是jdk的Image图片流占用,一般是文件读写用到的,并且两次dump中这部分没有变化,所以排除该项
剩下的那些增长的内存对象,一一进去查看,发现基本都是tomcat线程持有的BufferCache
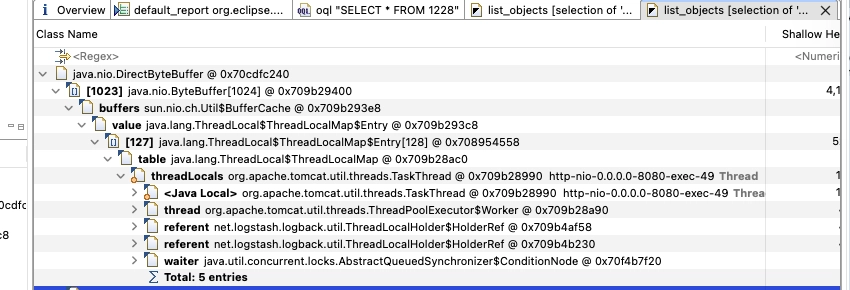
找AI问了一下BufferCache的机制
BufferCache是JDK使用直接内存的机制,每个线程都有自己的 BufferCache
BufferCache 里面缓存若干个 DirectByteBuffer
因为tomcat线程一直存在,这些线程持有BufferCache,导致这些直接内存不会被回收
根因
在之前,因为直接内存的问题,经常会导致运行一段时间后java进程的内存使用超出了pod的内存限制,触发内存告警,必须要找运维重启,否则也会被k8s给OOM kill掉
为了解决上述问题,服务端前任TL让运维加过jvm参数,限制直接内存的大小
-XX
=512m
但是这个只是缓解了这个问题,实际直接内存依旧因为BufferCache机制导致额外不断的增长,然后触发这次的这个问题
解决办法-短期
新增jvm启动项
-Djdk.nio.maxCachedBufferSize=1048576
限制单线程进行缓存的大小,设置为1M以后,大于1M的请求会直接走内存释放,不会走这个BufferCache。虽然会带来额外的内存申请和释放开销,但是本身对于上传文件这种经常>1M的场景,使用过的堆外内存就是应该释放掉
解决办法-长期
让AI帮忙分析了下代码,比较容易导致这个问题出现的点,后续也要排期修改:
最可疑的是灰度转发链路,其次是几个上传链路和 OkHttp 完整读响应链路。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 182 天
部分内容可能已过时